


기사 상세
[언론 통계 분석·활용 경진대회 수상 후기] 우수상 - ‘미니탯’ 팀
사람들이 신문과 방송을 떠나 포털과 유튜브로 옮겨 갔다는 이야기는 이제 새롭지 않다. 그래서 다음으로 우리는 무엇을 할 수 있을까?
<2025 언론수용자 조사>를 펼치자, 답의 방향이 보였다. 매체별 이용률은 각 채널을 몇 명이 쓰는지는 알려주지만, 한 사람이 그 채널들을 어떻게 조합해 쓰는지는 말해주지 않았다. TV만 보는 사람과 포털·유튜브·메신저·숏폼을 하루에도 몇 번씩 오가는 사람이 이용률 표 위에서는 똑같이 한 명으로 계산되는 것이다.
우리가 주목한 것은 소비량이 아니라 연결이었다. 뉴스가 숏폼과 카드뉴스로 파편화되면 이용자는 그 보도의 원 출처와 시점을 역추적하기 어려워진다. 검증의 기준점인 원문이 사라지면 판단의 근거도 함께 사라진다. 그래서 ‘얼마나 넓게 흩어져 있고, 원본 출처에서 얼마나 멀어졌는가’를 개인 단위로 재보기로 했다. 여기에 붙인 이름이 ‘뉴스 유목민 지수(NNI, News Nomad Index)’다.
분산도와 이탈도, 두 개의 축
응답자 6,000명의 11개 채널(종이신문·TV·라디오·시사잡지·포털·팟캐스트·메신저·SNS·온라인 동영상·숏폼·생성형 AI) 이용 빈도를 개인 단위로 재구성했다. 평일 이용일수(0~5)만 쓰면 주말 패턴이 통째로 빠지기에, 주말(0~2)을 더해 주간 총 이용일수(0~7)로 통합했다.
첫 번째 축 ‘분산도(H_norm)’는 한 사람의 이용량이 채널들에 얼마나 고르게 퍼져 있는지를 섀넌 엔트로피(Shannon entropy)1)로 계산하고 11개 채널을 모두 고르게 이용했을 때의 최댓값인 log211(약 3.459)을 기준으로 정규화한 값이다. 두 번째 축 ‘이탈도(D_weighted)’는 플랫폼이 콘텐츠 유통에 개입하는 정도에 따라 채널을 세 단계로 나눈 뒤 개인별 이용 빈도로 가중평균한 값이다. 전통 언론사가 직접 생산한 콘텐츠를 tier 0, 포털 등을 통해 매개·집성된 콘텐츠를 tier 1, 이용자에 의해 재유통·파편화된 콘텐츠가 tier 2다.
두 축을 어떤 비율로 합칠지는 연구자가 정하지 않고 주성분 분석에 맡겼는데, 제1주성분에서 두 축의 기여도가 사실상 동일해 α=β=0.5로 결정했다. 여기서 멈추지 않고 가중값 α를 0.1부터 0.9까지, 군집 수 K를 3부터 7까지, 기준점(시드)을 세 차례 달리해 전 구간을 다시 분석했다. K=5는 α와 무관하게 일관된 최고 실루엣2)을 보였고, K=5 고정 시 α 변동에 따른 실루엣 값의 변동폭은 0.5480~0.5540으로 0.006에 불과했다. 이렇듯 모든 것에 근거를 찾으며 분석을 이어 나갔다.
관여도 혼입 유무 확인
검증 단계도 층층이 쌓아 나갔다. 분산도와 총 이용일수의 상관계수가 0.824로 너무 높게 나왔다. 뉴스를 많이 보기만 하면 자동으로 유목민이 되는 지표라면 새 지수를 만들 이유가 없었다.
사이에 낀 변수는 ‘이용 채널 수’였다. 채널 수를 통제하자 이 상관계수는 0.824에서 0.142로 크게 낮아졌다. 반면 총 이용량을 통제해도 분산도와 채널 수의 상관계수는 0.950에서 0.837로 거의 유지됐다. 이 결과를 보면 분산도를 결정하는 것은 ‘얼마나 많이 보는가’가 아니라 ‘몇 개 채널에 걸쳐 보는가’였다. 실제로 여러 채널의 주간 이용일수 합계가 8~14일 구간 안에서만 봐도 분산도는 0.157에서 0.729까지 넓게 흩어져 있었다. 지적이 제기될 법한 지점을 미리 부순 이 계산은 발표에서 가장 오래 설명한 대목이 됐다.
점수는 같은데 정반대 자리에 앉은 두 집단
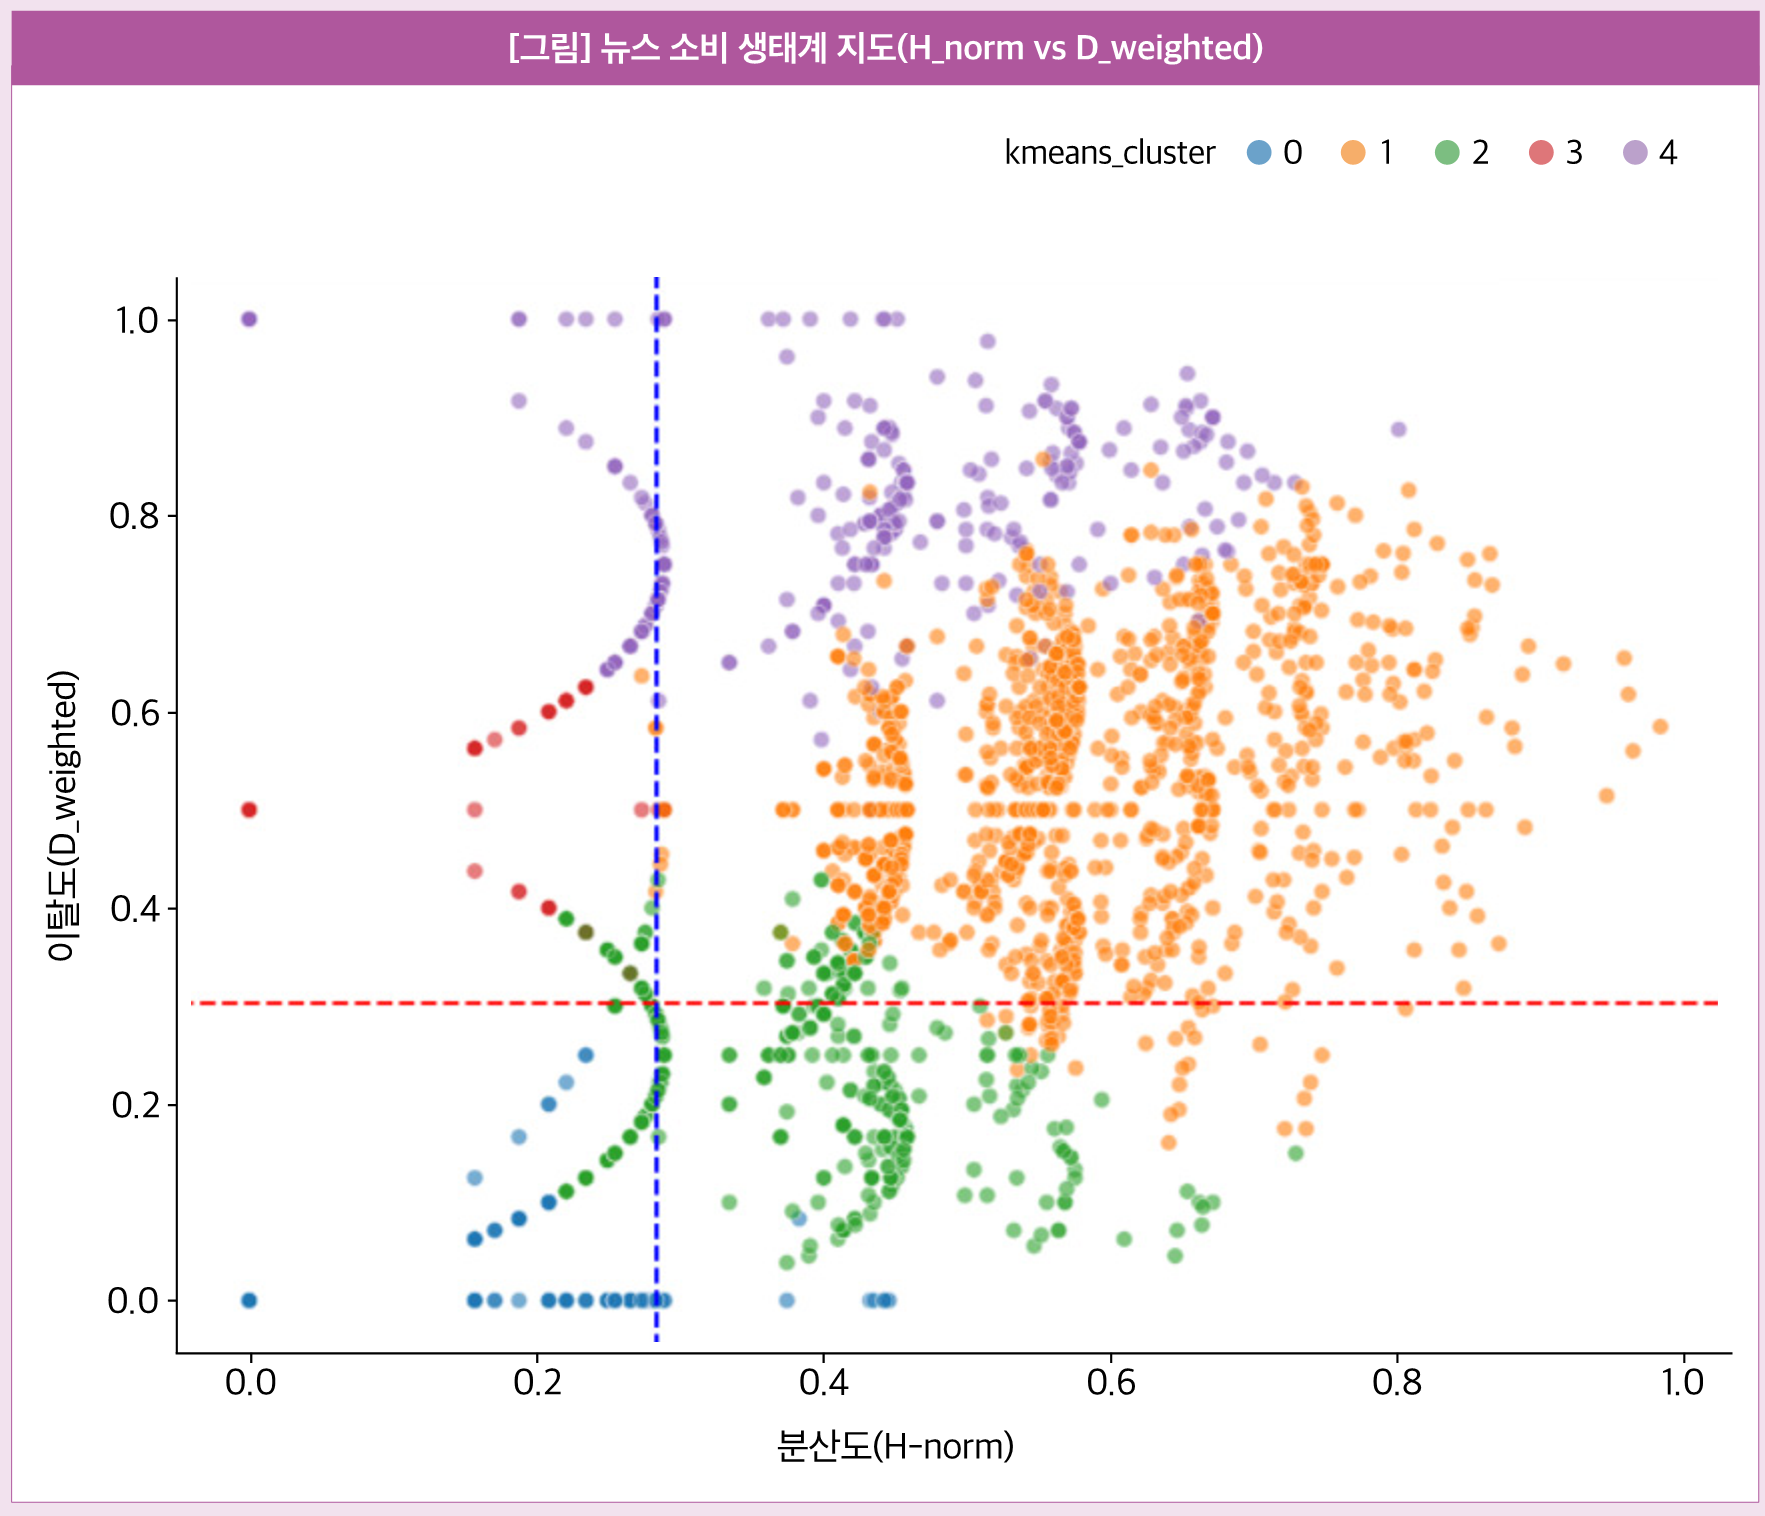
K-means 군집분석 결과 뉴스 활성층 5,702명은 다섯 유형으로 나뉘었다. 언론수용자 조사 전체 응답자 기준으로 TV 단일 전통층(29.0%), 전방위 옴니보어층(26.8%), 전통-포털 병행층(25.6%), 포털 단일 의존층(6.8%), 디지털 유목민층(7.0%) 등이다.
그중 전통-포털 병행층(NNI 0.271)과 포털 단일 의존층(NNI 0.266)은 지수 차이가 0.005, NNI 표준편차의 2.2%에 불과하다. 숫자만 보면 같은 유형의 사람들로 보인다. 그런데 두 축 평면에 찍어보니 서로 다른 사분면에 놓였다. 전자는 전통 매체를 주 6.05일 이용하는 평균 51.9세 집단이고, 후자는 전통 매체 이용이 주 0.05일인 평균 37.8세 집단이었다.
NNI는 α·H+β·D의 가중합이므로, 값이 같다는 것은 기울기 −1의 대각선 위 어딘가에 있다는 뜻일 뿐 어느 지점인지는 특정하지 못한다. 이 발견이 결과물의 형태를 바꿨다. 하나의 점수로 줄 세우는 대신, 두 축으로 이뤄진 ‘뉴스 소비 생태계 지도’를 함께 내놓기로 한 것이다. 인구통계 변수를 군집화에 전혀 넣지 않았는데도 소비 패턴만으로 다섯 집단이 평면상 서로 다른 영역을 점유한 것은, 두 지표가 유효한 좌표계라는 시각적 근거가 됐다.
흩어진 이유는 불신이 아니었다
지도가 그려지자 여러 가지 이야기를 할 수 있었다. 뉴스를 아예 보지 않는 층은 5.0%뿐이었다. 사람들은 뉴스를 안 보는 것이 아니라 흩어져 보고 있었다. 그렇다면 다음 질문은 자연히 ‘왜 흩어졌는가’였고, 우리 역시 가장 흔한 설명부터 검증했다. 언론을 믿지 못하니 전통 매체를 떠난다는 것이다.
디지털 유목민층의 뉴스 전반 신뢰도는 3.364로, 전통 매체에 잔류한 TV 단일 전통층 3.464와 0.1점 차이였다. 통계적으로는 유의했지만(t=2.93, p<.01) 효과크기는 0.151로 통상적인 '작은 효과' 기준 0.2에도 미치지 못했다. 불신이 이탈의 주된 요인이었다면 두 집단 사이에 상당한 신뢰도 격차가 있어야 하는데, 실제 격차는 그 설명을 뒷받침하기에 충분치 않았다.
대신 갈라진 것은 동선이었다. 디지털 유목민층의 전통 매체(tier 0) 이용은 주 0.14일, 파편화된 콘텐츠(tier 2) 채널 이용은 주 7.41일이다. 이들은 뉴스를 믿지 못해 원문을 안 본 것이 아니라, 애초에 원문과 만날 구조적 기회가 소비 동선에서 사라진 상태였다. 전통 매체 접점이 사실상 0인 집단은 13.8%에 달했다. 문제는 소비의 소멸이 아니라 접점의 상실이었다.
이 결론은 처방의 방향을 재설정해 줬다. 필요한 것은 ‘뉴스를 믿어달라’는 신뢰 회복 캠페인이 아니라, 이용자가 이미 머무는 동선 안에 원본 접점을 심는 설계다. 다만 처방은 유형마다 달라야 했다. 디지털 유목민층에게는 채널을 줄이라고 할 것이 아니라 이미 쓰는 숏폼·SNS 안에 원문으로 가는 경로를 만들어줘야 하고, 주 19.5일을 소비하는 전방위 옴니보어층에게는 중복 소비 정리가 필요하다. 그렇다면 어느 집단부터 개입할 것인가. 포털 단일 의존층과 디지털 유목민층은 이탈도 축에서 둘 다 ‘이탈했다’고 판정되지만, 우선순위를 매기려면 두 축을 하나로 합친 값이 필요했다. NNI 순으로 정렬하고 규모와 연령을 겹쳐 디지털 유목민층과 전방위 옴니보어층을 우선 타깃으로 골랐다. 두 축은 유형을 식별하는 좌표계로, NNI는 우선순위를 정하는 요약 지표로 서로를 보완한 셈이다.
진단에서 배포까지, ‘뉴스나침반’
여기까지의 지표를 그대로 코어 삼아 하나의 NNI 진단 엔진 위에 두 서비스를 얹었다. 이용자에게 소비 패턴을 진단하고 처방하는 ‘뉴스 닥터(B2C)’와 ‘이 군집 독자에게는 이렇게 배포하라’를 언론사에 제시하는 ‘배포 엔진(B2B)’이다.
둘은 별개의 도구가 아니라 같은 지표를 사용자층에 따라 다르게 쓴 두 가지 방식이다. 계산 결과를 개인에게 보여주면 진단 리포트가 되고, 언론사에 보여주면 배포 전략이 된다. 뉴스 닥터에 쌓인 비식별 소비 로그가 배포 엔진의 추천을 실측 기반으로 정교하게 만들고, 배포 성과가 다시 군집 분류를 다듬는 순환 구조로 설계했다. 기자가 기사를 디지털 유목민층 타깃으로 입력하면 엔진이 숏폼 스크립트를 추천하고, 출퇴근길에 그 숏폼을 접한 이용자가 ‘원문 보기’로 끊어진 접점을 복원하며, 그 반응이 다시 엔진에 축적된다. 하나의 기사가 언론사와 이용자 사이를 한 바퀴 도는 그림이다.
NNI는 단일 시점의 횡단면 조사를 기반으로 산출됐으므로, 연도별 조사에 반복 적용해 유목화의 시간적 추이를 추적하는 종단 분석이 후속 과제로 남는다. 또한 제안한 서비스 모델의 실효성은 실제 구현과 사용자 반응 로그를 통해 검증되어야 하며, 소비자 진단·언론사 배포·공공 통계가 서로 연계되는 선순환이 실측 데이터 위에서 얼마나 정교해지는지가 향후 검증의 핵심이 될 것이다.
<언론수용자 조사>는 매년 쌓이는 귀한 자료다. 그 안에는 아직 표로 요약되지 않은 개인 단위의 이야기가 남아 있다고 믿는다.
1) 값이 얼마나 고르게 분포하는지를 수치화한 지표로, 특정 범주에 몰릴 수록 값이 낮고 여러 범주에 고르게 퍼질수록 값이 높다. 편집자 주
2) 군집이 얼마나 잘 구분됐는지를 보여주는 지표로, -1과 1사이의 값을 가지며, 1에 가까울수록 다른 집단과 잘 구분된다는 의미다. 편집자 주
<2025 언론수용자 조사>를 펼치자, 답의 방향이 보였다. 매체별 이용률은 각 채널을 몇 명이 쓰는지는 알려주지만, 한 사람이 그 채널들을 어떻게 조합해 쓰는지는 말해주지 않았다. TV만 보는 사람과 포털·유튜브·메신저·숏폼을 하루에도 몇 번씩 오가는 사람이 이용률 표 위에서는 똑같이 한 명으로 계산되는 것이다.
우리가 주목한 것은 소비량이 아니라 연결이었다. 뉴스가 숏폼과 카드뉴스로 파편화되면 이용자는 그 보도의 원 출처와 시점을 역추적하기 어려워진다. 검증의 기준점인 원문이 사라지면 판단의 근거도 함께 사라진다. 그래서 ‘얼마나 넓게 흩어져 있고, 원본 출처에서 얼마나 멀어졌는가’를 개인 단위로 재보기로 했다. 여기에 붙인 이름이 ‘뉴스 유목민 지수(NNI, News Nomad Index)’다.
분산도와 이탈도, 두 개의 축
응답자 6,000명의 11개 채널(종이신문·TV·라디오·시사잡지·포털·팟캐스트·메신저·SNS·온라인 동영상·숏폼·생성형 AI) 이용 빈도를 개인 단위로 재구성했다. 평일 이용일수(0~5)만 쓰면 주말 패턴이 통째로 빠지기에, 주말(0~2)을 더해 주간 총 이용일수(0~7)로 통합했다.
첫 번째 축 ‘분산도(H_norm)’는 한 사람의 이용량이 채널들에 얼마나 고르게 퍼져 있는지를 섀넌 엔트로피(Shannon entropy)1)로 계산하고 11개 채널을 모두 고르게 이용했을 때의 최댓값인 log211(약 3.459)을 기준으로 정규화한 값이다. 두 번째 축 ‘이탈도(D_weighted)’는 플랫폼이 콘텐츠 유통에 개입하는 정도에 따라 채널을 세 단계로 나눈 뒤 개인별 이용 빈도로 가중평균한 값이다. 전통 언론사가 직접 생산한 콘텐츠를 tier 0, 포털 등을 통해 매개·집성된 콘텐츠를 tier 1, 이용자에 의해 재유통·파편화된 콘텐츠가 tier 2다.
두 축을 어떤 비율로 합칠지는 연구자가 정하지 않고 주성분 분석에 맡겼는데, 제1주성분에서 두 축의 기여도가 사실상 동일해 α=β=0.5로 결정했다. 여기서 멈추지 않고 가중값 α를 0.1부터 0.9까지, 군집 수 K를 3부터 7까지, 기준점(시드)을 세 차례 달리해 전 구간을 다시 분석했다. K=5는 α와 무관하게 일관된 최고 실루엣2)을 보였고, K=5 고정 시 α 변동에 따른 실루엣 값의 변동폭은 0.5480~0.5540으로 0.006에 불과했다. 이렇듯 모든 것에 근거를 찾으며 분석을 이어 나갔다.
관여도 혼입 유무 확인
검증 단계도 층층이 쌓아 나갔다. 분산도와 총 이용일수의 상관계수가 0.824로 너무 높게 나왔다. 뉴스를 많이 보기만 하면 자동으로 유목민이 되는 지표라면 새 지수를 만들 이유가 없었다.
사이에 낀 변수는 ‘이용 채널 수’였다. 채널 수를 통제하자 이 상관계수는 0.824에서 0.142로 크게 낮아졌다. 반면 총 이용량을 통제해도 분산도와 채널 수의 상관계수는 0.950에서 0.837로 거의 유지됐다. 이 결과를 보면 분산도를 결정하는 것은 ‘얼마나 많이 보는가’가 아니라 ‘몇 개 채널에 걸쳐 보는가’였다. 실제로 여러 채널의 주간 이용일수 합계가 8~14일 구간 안에서만 봐도 분산도는 0.157에서 0.729까지 넓게 흩어져 있었다. 지적이 제기될 법한 지점을 미리 부순 이 계산은 발표에서 가장 오래 설명한 대목이 됐다.
점수는 같은데 정반대 자리에 앉은 두 집단
K-means 군집분석 결과 뉴스 활성층 5,702명은 다섯 유형으로 나뉘었다. 언론수용자 조사 전체 응답자 기준으로 TV 단일 전통층(29.0%), 전방위 옴니보어층(26.8%), 전통-포털 병행층(25.6%), 포털 단일 의존층(6.8%), 디지털 유목민층(7.0%) 등이다.
그중 전통-포털 병행층(NNI 0.271)과 포털 단일 의존층(NNI 0.266)은 지수 차이가 0.005, NNI 표준편차의 2.2%에 불과하다. 숫자만 보면 같은 유형의 사람들로 보인다. 그런데 두 축 평면에 찍어보니 서로 다른 사분면에 놓였다. 전자는 전통 매체를 주 6.05일 이용하는 평균 51.9세 집단이고, 후자는 전통 매체 이용이 주 0.05일인 평균 37.8세 집단이었다.
NNI는 α·H+β·D의 가중합이므로, 값이 같다는 것은 기울기 −1의 대각선 위 어딘가에 있다는 뜻일 뿐 어느 지점인지는 특정하지 못한다. 이 발견이 결과물의 형태를 바꿨다. 하나의 점수로 줄 세우는 대신, 두 축으로 이뤄진 ‘뉴스 소비 생태계 지도’를 함께 내놓기로 한 것이다. 인구통계 변수를 군집화에 전혀 넣지 않았는데도 소비 패턴만으로 다섯 집단이 평면상 서로 다른 영역을 점유한 것은, 두 지표가 유효한 좌표계라는 시각적 근거가 됐다.
흩어진 이유는 불신이 아니었다
지도가 그려지자 여러 가지 이야기를 할 수 있었다. 뉴스를 아예 보지 않는 층은 5.0%뿐이었다. 사람들은 뉴스를 안 보는 것이 아니라 흩어져 보고 있었다. 그렇다면 다음 질문은 자연히 ‘왜 흩어졌는가’였고, 우리 역시 가장 흔한 설명부터 검증했다. 언론을 믿지 못하니 전통 매체를 떠난다는 것이다.
디지털 유목민층의 뉴스 전반 신뢰도는 3.364로, 전통 매체에 잔류한 TV 단일 전통층 3.464와 0.1점 차이였다. 통계적으로는 유의했지만(t=2.93, p<.01) 효과크기는 0.151로 통상적인 '작은 효과' 기준 0.2에도 미치지 못했다. 불신이 이탈의 주된 요인이었다면 두 집단 사이에 상당한 신뢰도 격차가 있어야 하는데, 실제 격차는 그 설명을 뒷받침하기에 충분치 않았다.
대신 갈라진 것은 동선이었다. 디지털 유목민층의 전통 매체(tier 0) 이용은 주 0.14일, 파편화된 콘텐츠(tier 2) 채널 이용은 주 7.41일이다. 이들은 뉴스를 믿지 못해 원문을 안 본 것이 아니라, 애초에 원문과 만날 구조적 기회가 소비 동선에서 사라진 상태였다. 전통 매체 접점이 사실상 0인 집단은 13.8%에 달했다. 문제는 소비의 소멸이 아니라 접점의 상실이었다.
이 결론은 처방의 방향을 재설정해 줬다. 필요한 것은 ‘뉴스를 믿어달라’는 신뢰 회복 캠페인이 아니라, 이용자가 이미 머무는 동선 안에 원본 접점을 심는 설계다. 다만 처방은 유형마다 달라야 했다. 디지털 유목민층에게는 채널을 줄이라고 할 것이 아니라 이미 쓰는 숏폼·SNS 안에 원문으로 가는 경로를 만들어줘야 하고, 주 19.5일을 소비하는 전방위 옴니보어층에게는 중복 소비 정리가 필요하다. 그렇다면 어느 집단부터 개입할 것인가. 포털 단일 의존층과 디지털 유목민층은 이탈도 축에서 둘 다 ‘이탈했다’고 판정되지만, 우선순위를 매기려면 두 축을 하나로 합친 값이 필요했다. NNI 순으로 정렬하고 규모와 연령을 겹쳐 디지털 유목민층과 전방위 옴니보어층을 우선 타깃으로 골랐다. 두 축은 유형을 식별하는 좌표계로, NNI는 우선순위를 정하는 요약 지표로 서로를 보완한 셈이다.
진단에서 배포까지, ‘뉴스나침반’
여기까지의 지표를 그대로 코어 삼아 하나의 NNI 진단 엔진 위에 두 서비스를 얹었다. 이용자에게 소비 패턴을 진단하고 처방하는 ‘뉴스 닥터(B2C)’와 ‘이 군집 독자에게는 이렇게 배포하라’를 언론사에 제시하는 ‘배포 엔진(B2B)’이다.
둘은 별개의 도구가 아니라 같은 지표를 사용자층에 따라 다르게 쓴 두 가지 방식이다. 계산 결과를 개인에게 보여주면 진단 리포트가 되고, 언론사에 보여주면 배포 전략이 된다. 뉴스 닥터에 쌓인 비식별 소비 로그가 배포 엔진의 추천을 실측 기반으로 정교하게 만들고, 배포 성과가 다시 군집 분류를 다듬는 순환 구조로 설계했다. 기자가 기사를 디지털 유목민층 타깃으로 입력하면 엔진이 숏폼 스크립트를 추천하고, 출퇴근길에 그 숏폼을 접한 이용자가 ‘원문 보기’로 끊어진 접점을 복원하며, 그 반응이 다시 엔진에 축적된다. 하나의 기사가 언론사와 이용자 사이를 한 바퀴 도는 그림이다.
NNI는 단일 시점의 횡단면 조사를 기반으로 산출됐으므로, 연도별 조사에 반복 적용해 유목화의 시간적 추이를 추적하는 종단 분석이 후속 과제로 남는다. 또한 제안한 서비스 모델의 실효성은 실제 구현과 사용자 반응 로그를 통해 검증되어야 하며, 소비자 진단·언론사 배포·공공 통계가 서로 연계되는 선순환이 실측 데이터 위에서 얼마나 정교해지는지가 향후 검증의 핵심이 될 것이다.
<언론수용자 조사>는 매년 쌓이는 귀한 자료다. 그 안에는 아직 표로 요약되지 않은 개인 단위의 이야기가 남아 있다고 믿는다.
1) 값이 얼마나 고르게 분포하는지를 수치화한 지표로, 특정 범주에 몰릴 수록 값이 낮고 여러 범주에 고르게 퍼질수록 값이 높다. 편집자 주
2) 군집이 얼마나 잘 구분됐는지를 보여주는 지표로, -1과 1사이의 값을 가지며, 1에 가까울수록 다른 집단과 잘 구분된다는 의미다. 편집자 주
저자의 다른 미디어


